From df3c438093e0cf2ebd114c0d301400655a7fa486 Mon Sep 17 00:00:00 2001
From: RiskeyL <7a8y@163.com>
Date: Fri, 20 Nov 2026 17:55:12 +0800
Subject: [PATCH 1/3] translate: fix older chinese wording on four knowledge
and extension pages
---
.../import-text-data/readme.mdx | 12 +++---
.../manage-knowledge/introduction.mdx | 4 +-
.../use-dify/nodes/knowledge-retrieval.mdx | 38 ++++++++++---------
.../workspace/api-extension/api-extension.mdx | 28 +++++++-------
.../import-text-data/readme.mdx | 10 ++---
.../manage-knowledge/introduction.mdx | 4 +-
.../use-dify/nodes/knowledge-retrieval.mdx | 38 ++++++++++---------
.../workspace/api-extension/api-extension.mdx | 28 +++++++-------
8 files changed, 83 insertions(+), 79 deletions(-)
diff --git a/zh/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx b/zh/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
index 2dc522a54f..976b4b62cf 100644
--- a/zh/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
+++ b/zh/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
@@ -14,7 +14,7 @@ title: 上传本地文件
2. 选择 **导入已有文本** 作为数据源,然后上传文件。
-上传限制因套餐而异([了解更多](https://dify.ai/zh/pricing)):
+上传限制因套餐而异:
| | Sandbox | Professional 和 Team |
|:--|:--|:--|
@@ -22,22 +22,22 @@ title: 上传本地文件
| 单个文件大小 | 15 MB | 50 MB |
---
-**对于文件中的图片**
+**上传文件中的图片**
JPG、JPEG、PNG 和 GIF 格式且小于 2 MB 的图片将作为附件,自动提取到对应的分段。这些图片可独立管理,并在检索时与分段一同返回。
- 提取的图片 URL 会保留在分段文本中,但你可以放心删除这些 URL 以保持文本整洁,这不会影响已提取的图片。
+ 提取出的图片 URL 会保留在分段文本中。如需保持文本整洁,可放心删除这些 URL,已提取的图片不受影响。
- 若在索引设置中选择多模态嵌入模型(带有 **Vision** 图标),则提取出的图片也将被向量化并索引以供检索。
+ 若在索引设置中选择多模态嵌入模型(带有 **Vision** 图标),Dify 还会为提取出的图片生成嵌入并建立索引,供检索使用。
- 每个分段最多支持 10 个图片附件,超出的图片不会被提取。
+ 每个分段最多支持 10 个图片附件,超出的图片不会提取。
以上提取规则适用于如下图片类型:
- DOCX 和 XLSX 文件中嵌入的图片
- 其他文件类型(如 PDF)中嵌入的图片,可通过在 [知识流水线](/zh/cloud/use-dify/knowledge/knowledge-pipeline/readme) 中使用合适的文档提取插件进行提取。
+ 如需提取其他文件类型(如 PDF)中嵌入的图片,可在 [知识流水线](/zh/cloud/use-dify/knowledge/knowledge-pipeline/readme) 中使用合适的文档提取插件。
- 在任何文件类型中,通过以下 Markdown 语法引用、URL 可访问的图片:
diff --git a/zh/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx b/zh/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
index 6bbf4ee1ea..265fff0704 100644
--- a/zh/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
+++ b/zh/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
@@ -15,8 +15,8 @@ sidebarTitle: 设置
|:----------------------- |:---------------------|
| 名称和图标 | 用于标识和区分知识库。|
| 描述 | 简要说明知识库的用途和内容。|
-| 权限 | 定义哪些工作空间成员可访问该知识库。被授予访问权限的成员将拥有 [维护知识库内容](/zh/cloud/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) 中列出的全部权限。|
+| 权限 | 定义哪些工作空间成员可访问该知识库。有权访问该知识库的成员拥有 [维护知识库内容](/zh/cloud/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) 中列出的全部权限。|
| 索引方式 | 决定文档分段的处理和组织方式。详见 [选择索引方式](/zh/cloud/use-dify/knowledge/create-knowledge/setting-indexing-methods#选择索引方式)。|
-| 嵌入模型 | 选择用于将文档分段转化为向量的嵌入模型。更换嵌入模型将对所有分段重新进行向量化。|
+| 嵌入模型 | 指定嵌入模型,用于将文档分段转换为向量。更换嵌入模型会重新嵌入所有分段。|
| 摘要自动生成 | 自动为文档分段生成摘要。启用后,仅对新添加的文档和分段生效。对于已有分段,请在文档列表中选择文档,然后点击 **生成摘要**。|
| 检索设置 | 决定知识库如何检索相关内容。详见 [指定检索设置](/zh/cloud/use-dify/knowledge/create-knowledge/setting-indexing-methods#指定检索设置)。|
diff --git a/zh/cloud/use-dify/nodes/knowledge-retrieval.mdx b/zh/cloud/use-dify/nodes/knowledge-retrieval.mdx
index dfe5e74b6a..aecd27b93a 100644
--- a/zh/cloud/use-dify/nodes/knowledge-retrieval.mdx
+++ b/zh/cloud/use-dify/nodes/knowledge-retrieval.mdx
@@ -9,7 +9,7 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
此节点检索 [经典知识库](/zh/cloud/use-dify/knowledge/readme)。如需检索 Agent 知识库,改用 [Agent 知识检索节点](/zh/cloud/use-dify/nodes/knowledge-retrieval-v2)。
-你可以通过知识检索节点将已有知识库集成到 Chatflow 或 Workflow 应用中。该节点在指定知识库中检索与查询相关的信息,并将检索结果作为上下文内容传递给下游节点(如 LLM)使用。
+知识检索节点可将已有知识库接入工作流。它在指定知识库中检索与查询相关的信息,并将结果作为上下文输出,供下游节点(如 LLM)使用。
知识检索节点在 Chatflow 中的典型用例如下:
@@ -25,7 +25,7 @@ description: 从经典知识库中检索相关内容,作为下游节点的上

-使用知识检索节点前,确保至少有一个可用的知识库。了解如何创建知识库,阅读 [知识库](/zh/cloud/use-dify/knowledge/readme#set-up)。
+使用知识检索节点前,确保至少有一个可用的知识库。创建知识库的方法详见 [知识库](/zh/cloud/use-dify/knowledge/readme#set-up)。
知识检索操作受每分钟频率限制,具体数值因订阅计划而异。各计划的限额详见 [知识库请求频率限制](/zh/cloud/use-dify/knowledge/knowledge-request-rate-limit)。
@@ -33,7 +33,7 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
## 配置知识检索节点
-要使知识检索节点正常工作,你需要指定:
+知识检索节点需指定以下内容才能正常工作:
- **检索什么**(查询内容)
@@ -41,20 +41,20 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
- **如何处理检索结果**(节点级检索设置)
-你还可以利用文档元数据实现基于筛选的检索,进一步提升检索精度。
+还可按文档元数据筛选检索范围,进一步提升检索精度。
### 指定查询内容
-设置节点需要在指定知识库中检索的查询内容。
+提供查询内容,节点会据此在所选知识库中检索。
-- **查询文本**:选择一个文本变量。例如,在 Chatflow 中可用 `userinput.query` 引用用户输入,而在 Workflow 中则可选择文本类型的用户输入变量。
+- **查询文本**:选择一个文本变量。例如,在 Chatflow 中可用 `userinput.query` 引用用户输入,在 Workflow 中可选择自定义的文本类型用户输入变量。
- **查询图片**:选择一个图片变量(如用户通过用户输入节点上传的图片),通过图片进行检索。每张图片不得超过 2 MB。
当添加了至少一个多模态知识库时,才会出现 **查询图片** 选项。
- 此类知识库会带有 **Vision** 图标,表示其使用的是多模态嵌入模型。
+ 此类知识库带有 **Vision** 标签,表示使用了多模态嵌入模型。
### 选择检索的知识库
@@ -64,14 +64,14 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
添加了多个知识库时,会同时检索所有知识库,合并结果并根据 [节点级检索设置](#调整节点级检索设置) 进行处理。
- 带有 **Vision** 图标的知识库支持跨模态检索:基于语义相关性同时检索文本和图片。
+ 带有 **Vision** 标签的知识库支持跨模态检索:按语义相关性同时返回文本和图片。
点击已添加知识库旁的 **编辑** 图标,可修改该知识库的 [设置](/zh/cloud/use-dify/knowledge/manage-knowledge/introduction)。
### 调整节点级检索设置
-设置节点在获取知识库检索结果后的处理方式。
+如需微调节点对检索结果的处理方式,点击 **召回设置**。
检索设置分为知识库级和节点级两层。
@@ -91,17 +91,17 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
- **Rerank 模型**
- 根据与查询内容的相关性,对所有结果的相似度分数进行重新评定和排序。
+ 该模型根据结果与查询内容的相关性,重新打分并排序。
- 若添加了多模态知识库,需同时选择多模态 Rerank 模型(带有 **Vision** 图标)。否则,检索到的图片将在重排序和最终输出中被排除。
+ 若添加了多模态知识库,还需选择多模态重排序模型(带有 **Vision** 标签)。否则,检索到的图片不会参与重排序,也不会出现在最终输出中。
- **Top K**
重排序后返回的最大结果数。
- 选择 Rerank 模型时,该值将根据模型的最大输入容量自动调整。
+ 选择重排序模型后,该值会根据模型的最大输入容量(即模型一次能处理的文本量)自动调整。
- **Score 阈值**
@@ -109,9 +109,9 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
### 启用元数据过滤
-可利用已有的文档元数据,将检索范围限定在知识库的特定文档内,以进一步提升检索精度。
+默认情况下,检索范围覆盖整个知识库。如需只检索特定文档,可启用手动或自动元数据过滤。
-启用元数据过滤后,知识检索节点仅会检索符合指定元数据过滤条件的文档,而非整个知识库。尤其适用于内容多样的大型知识库。
+启用后检索更精确,在知识库规模较大或内容涉及多种场景时尤其有效。
关于创建和管理文档元数据,详见 [元数据](/zh/cloud/use-dify/knowledge/metadata)。
@@ -123,14 +123,16 @@ description: 从经典知识库中检索相关内容,作为下游节点的上
## 搭配 LLM 节点使用知识检索节点
-如需在 LLM 节点中基于检索结果回答用户问题:
+如需在 LLM 节点中将检索结果用作上下文:
1. 在 **上下文** 字段中,选择知识检索节点的 `result` 变量。
-2. 在提示词字段中,同时引用 `上下文` 变量和用户输入变量(如 Chatflow 中的 `userinput.query`)。
+2. 在系统指令中引用 `上下文` 变量。
-3. (可选)若 LLM 支持视觉能力(带有 **Vision** 图标),可启用 **Vision**,以便其理解检索到的图片。
+3. (可选)若 LLM 支持视觉能力,可启用 **视觉**,处理检索结果中的图片附件。
- 启用 **Vision** 后,LLM 会自动处理检索到的图片。无需在 **Vision** 输入字段中再次手动引用 `上下文` 变量。
+ 无需将检索结果指定为视觉输入。启用 **视觉** 后,LLM 会自动获取检索到的所有图片。
+
+在 Chatflow 中,回复若引用了知识库内容,默认会一并显示引用来源。如不需要,可在画布右上角的 **功能** 中关闭 **[引用和归属](/zh/cloud/use-dify/build/additional-features#引用与归属)**。
diff --git a/zh/cloud/use-dify/workspace/api-extension/api-extension.mdx b/zh/cloud/use-dify/workspace/api-extension/api-extension.mdx
index b2b5589477..a8825edb5b 100644
--- a/zh/cloud/use-dify/workspace/api-extension/api-extension.mdx
+++ b/zh/cloud/use-dify/workspace/api-extension/api-extension.mdx
@@ -7,16 +7,16 @@ sidebarTitle: 概述
开发者可通过自定义端点扩展模块能力,当前支持以下模块扩展:
-* `moderation` 敏感内容审计
+* `moderation` 敏感内容审核
* `external_data_tool` 外部数据工具
-在扩展模块能力之前,你需要准备一个 API 和用于鉴权的 API Key。
+扩展模块能力前,你需要准备一个 API,以及用于鉴权的 API 密钥。
除了需要开发对应的模块能力,还需要遵照以下规范,以便 Dify 正确调用 API。
## API 规范
-Dify 将会以以下规范调用你的接口:
+Dify 按以下规范调用你的接口:
```
POST {Your-API-Endpoint}
@@ -27,7 +27,7 @@ POST {Your-API-Endpoint}
| Header | Value | Desc |
| --------------- | ----------------- | --------------------------------------------------------------------- |
| `Content-Type` | application/json | 请求内容为 JSON 格式。 |
-| `Authorization` | Bearer \{api_key\} | API Key 以 Token 令牌的方式传输,你需要解析该 `api_key` 并确认是否和提供的 API Key 一致,保证接口安全。 |
+| `Authorization` | Bearer \{api_key\} | API 密钥以令牌形式传输。为保证接口安全,你需要解析出 `api_key`,核对它与所提供的 API 密钥是否一致。 |
### Request Body
@@ -50,7 +50,7 @@ POST {Your-API-Endpoint}
## 校验
-在 Dify 配置自定义端点时,Dify 将会发送一个请求至 API Endpoint,以检验 API 的可用性。
+配置自定义端点时,Dify 会向 API Endpoint 发送一个请求,检验该 API 是否可用。
当 API Endpoint 接收到 `point=ping` 时,接口应返回 `result=pong`,具体如下:
@@ -190,16 +190,16 @@ Authorization: Bearer 123456
else:
return {"result": "Unknown city"}
```
-3. 启动 API 服务,默认端口为 8000,API 完整地址为:`http://127.0.0.1:8000/api/dify/receive`,配置的 API Key 为 `123456`。
+3. 启动 API 服务。默认端口为 8000,API 完整地址是 `http://127.0.0.1:8000/api/dify/receive`,配置的 API 密钥是 `123456`。
```
uvicorn main:app --reload --host 0.0.0.0
```
4. 在 Dify 配置该 API。
-5. 在 App 中选择该自定义端点。
+5. 在应用中选择该自定义端点。
-App 调试时,Dify 将请求配置的 API,并发送以下内容(范例):
+调试应用时,Dify 会请求已配置的 API,并发送以下内容(范例):
```
{
@@ -225,7 +225,7 @@ API 返回为:
## 本地调试
-由于 Dify 无法访问内网 API 服务,为了方便本地调试 API 服务,可以使用 [Ngrok](https://ngrok.com) 将 API 服务的端点暴露到公网,实现云端调试本地代码。操作步骤:
+Dify 无法访问你内网中的 API 服务。借助 [Ngrok](https://ngrok.com) 将 API 服务的端点暴露到公网,即可在云端调试本地代码。操作步骤:
1. 进入 [https://ngrok.com](https://ngrok.com) 官网,注册并下载 Ngrok 文件。
@@ -256,14 +256,14 @@ API 返回为:
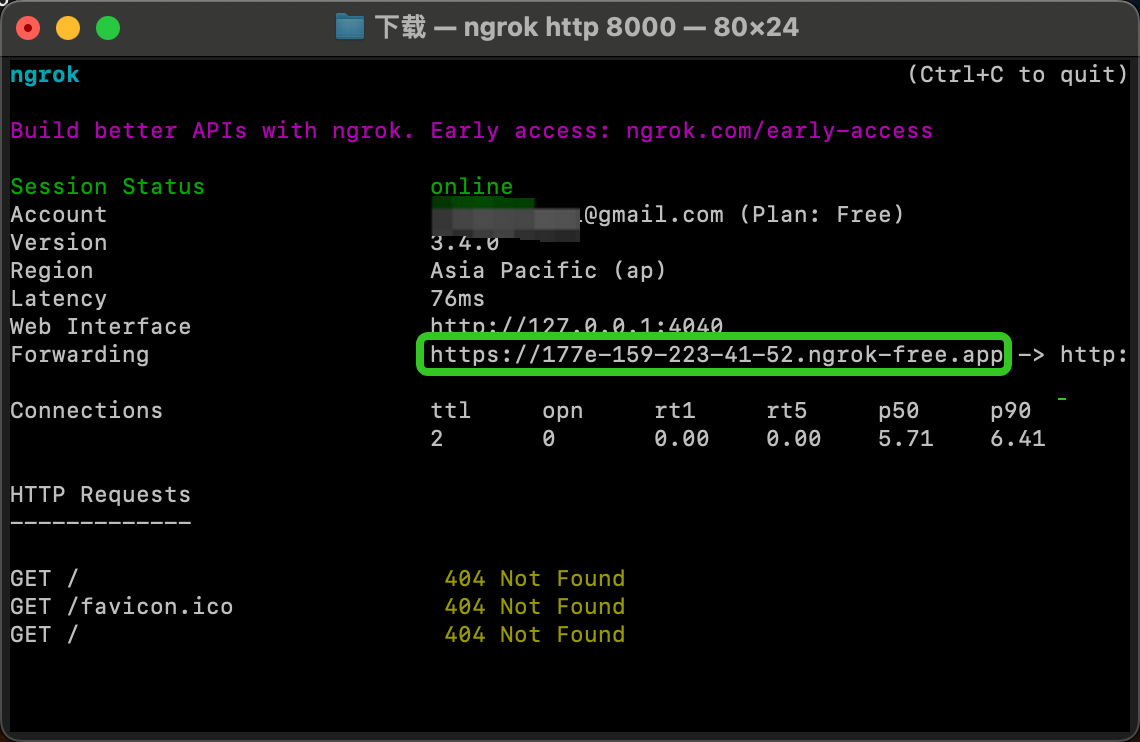
-4. 我们找到 Forwarding 中,如上图:`https://177e-159-223-41-52.ngrok-free.app`(此为示例域名,请替换为自己的)即为公网域名。
+4. 找到 Forwarding 一项对应的地址,即公网域名,如上图中的 `https://177e-159-223-41-52.ngrok-free.app`(此为示例域名,请替换为你自己的域名)。
-按照上述的范例,我们把本地已经启动的服务端点暴露出去,将代码范例接口:`http://127.0.0.1:8000/api/dify/receive` 替换为 `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive`
+沿用上面的范例:将本地已启动的服务端点暴露到公网后,把代码范例中的接口地址 `http://127.0.0.1:8000/api/dify/receive` 替换为 `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive`。
-此 API 端点即可公网访问。至此,我们即可在 Dify 配置该 API 端点进行本地调试代码,配置步骤请参考 [外部数据工具](/zh/cloud/use-dify/workspace/api-extension/external-data-tool-api-extension)。
+此 API 端点即可通过公网访问。现在可在 Dify 中配置该 API 端点来调试本地代码。配置步骤参见 [外部数据工具](/zh/cloud/use-dify/workspace/api-extension/external-data-tool-api-extension)。
## 使用 Cloudflare Workers 部署自定义端点
-我们推荐你使用 Cloudflare Workers 来部署你的自定义端点,因为 Cloudflare Workers 可以方便的提供一个公网地址,而且可以免费使用。
+推荐使用 Cloudflare Workers 部署自定义端点:它能便捷地提供公网地址,且可免费使用。
-详细说明请参考 [使用 Cloudflare Workers 部署自定义端点](/zh/cloud/use-dify/workspace/api-extension/cloudflare-worker)。
+详见 [使用 Cloudflare Workers 部署自定义端点](/zh/cloud/use-dify/workspace/api-extension/cloudflare-worker)。
diff --git a/zh/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx b/zh/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
index 197aced7a2..8d0401336f 100644
--- a/zh/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
+++ b/zh/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
@@ -20,22 +20,22 @@ title: 上传本地文件
---
-**对于文件中的图片**
+**上传文件中的图片**
JPG、JPEG、PNG 和 GIF 格式且小于 2 MB 的图片将作为附件,自动提取到对应的分段。这些图片可独立管理,并在检索时与分段一同返回。
- 提取的图片 URL 会保留在分段文本中,但你可以放心删除这些 URL 以保持文本整洁,这不会影响已提取的图片。
+ 提取出的图片 URL 会保留在分段文本中。如需保持文本整洁,可放心删除这些 URL,已提取的图片不受影响。
- 若在索引设置中选择多模态嵌入模型(带有 **Vision** 图标),则提取出的图片也将被向量化并索引以供检索。
+ 若在索引设置中选择多模态嵌入模型(带有 **Vision** 图标),Dify 还会为提取出的图片生成嵌入并建立索引,供检索使用。
- 每个分段最多支持 10 个图片附件(通过 `SINGLE_CHUNK_ATTACHMENT_LIMIT` 设置),超出的图片不会被提取。图片尺寸限制由 `ATTACHMENT_IMAGE_FILE_SIZE_LIMIT` 控制。
+ 每个分段最多支持 10 个图片附件(通过 `SINGLE_CHUNK_ATTACHMENT_LIMIT` 设置),超出的图片不会提取。图片的文件大小上限由 `ATTACHMENT_IMAGE_FILE_SIZE_LIMIT` 控制。
以上提取规则适用于如下图片类型:
- DOCX 和 XLSX 文件中嵌入的图片
- 其他文件类型(如 PDF)中嵌入的图片,可通过在 [知识流水线](/zh/self-host/use-dify/knowledge/knowledge-pipeline/readme) 中使用合适的文档提取插件进行提取。
+ 如需提取其他文件类型(如 PDF)中嵌入的图片,可在 [知识流水线](/zh/self-host/use-dify/knowledge/knowledge-pipeline/readme) 中使用合适的文档提取插件。
- 在任何文件类型中,通过以下 Markdown 语法引用、URL 可访问的图片:
diff --git a/zh/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx b/zh/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
index e06b4a1897..304090ce32 100644
--- a/zh/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
+++ b/zh/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
@@ -15,9 +15,9 @@ sidebarTitle: 设置
|:----------------------- |:---------------------|
| 名称和图标 | 用于标识和区分知识库。|
| 描述 | 简要说明知识库的用途和内容。|
-| 权限 | 定义哪些工作空间成员可访问该知识库。被授予访问权限的成员将拥有 [维护知识库内容](/zh/self-host/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) 中列出的全部权限。|
+| 权限 | 定义哪些工作空间成员可访问该知识库。有权访问该知识库的成员拥有 [维护知识库内容](/zh/self-host/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) 中列出的全部权限。|
| 索引方式 | 决定文档分段的处理和组织方式。详见 [选择索引方式](/zh/self-host/use-dify/knowledge/create-knowledge/setting-indexing-methods#选择索引方式)。|
-| 嵌入模型 | 选择用于将文档分段转化为向量的嵌入模型。更换嵌入模型将对所有分段重新进行向量化。|
+| 嵌入模型 | 指定嵌入模型,用于将文档分段转换为向量。更换嵌入模型会重新嵌入所有分段。|
| 摘要自动生成 | 自动为文档分段生成摘要。启用后,仅对新添加的文档和分段生效。对于已有分段,请在文档列表中选择文档,然后点击 **生成摘要**。|
| 检索设置 | 决定知识库如何检索相关内容。详见 [指定检索设置](/zh/self-host/use-dify/knowledge/create-knowledge/setting-indexing-methods#指定检索设置)。|
| 文件安全扫描 | 在索引前扫描新上传的文件是否含有恶意软件。部署环境启用该功能后才会显示。设置方法和各选项详见 [扫描上传文件中的恶意软件](/zh/self-host/use-dify/knowledge/file-security-scan)。|
diff --git a/zh/self-host/use-dify/nodes/knowledge-retrieval.mdx b/zh/self-host/use-dify/nodes/knowledge-retrieval.mdx
index 8c780a20c0..f4ae12fbf2 100644
--- a/zh/self-host/use-dify/nodes/knowledge-retrieval.mdx
+++ b/zh/self-host/use-dify/nodes/knowledge-retrieval.mdx
@@ -5,7 +5,7 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
> 本文档由 AI 自动翻译。如有任何不准确之处,请参考 [英文原版](/en/self-host/use-dify/nodes/knowledge-retrieval)。
-你可以通过知识检索节点将已有知识库集成到 Chatflow 或 Workflow 应用中。该节点在指定知识库中检索与查询相关的信息,并将检索结果作为上下文内容传递给下游节点(如 LLM)使用。
+知识检索节点可将已有知识库接入工作流。它在指定知识库中检索与查询相关的信息,并将结果作为上下文输出,供下游节点(如 LLM)使用。
知识检索节点在 Chatflow 中的典型用例如下:
@@ -21,11 +21,11 @@ description: 从知识库中检索相关内容,作为下游节点的上下文

-使用知识检索节点前,确保至少有一个可用的知识库。了解如何创建知识库,阅读 [知识库](/zh/self-host/use-dify/knowledge/readme#set-up)。
+使用知识检索节点前,确保至少有一个可用的知识库。创建知识库的方法详见 [知识库](/zh/self-host/use-dify/knowledge/readme#set-up)。
## 配置知识检索节点
-要使知识检索节点正常工作,你需要指定:
+知识检索节点需指定以下内容才能正常工作:
- **检索什么**(查询内容)
@@ -33,13 +33,13 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
- **如何处理检索结果**(节点级检索设置)
-你还可以利用文档元数据实现基于筛选的检索,进一步提升检索精度。
+还可按文档元数据筛选检索范围,进一步提升检索精度。
### 指定查询内容
-设置节点需要在指定知识库中检索的查询内容。
+提供查询内容,节点会据此在所选知识库中检索。
-- **查询文本**:选择一个文本变量。例如,在 Chatflow 中可用 `userinput.query` 引用用户输入,而在 Workflow 中则可选择文本类型的用户输入变量。
+- **查询文本**:选择一个文本变量。例如,在 Chatflow 中可用 `userinput.query` 引用用户输入,在 Workflow 中可选择自定义的文本类型用户输入变量。
- **查询图片**:选择一个图片变量(如用户通过用户输入节点上传的图片),通过图片进行检索。
@@ -48,7 +48,7 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
当添加了至少一个多模态知识库时,才会出现 **查询图片** 选项。
- 此类知识库会带有 **Vision** 图标,表示其使用的是多模态嵌入模型。
+ 此类知识库带有 **Vision** 标签,表示使用了多模态嵌入模型。
### 选择检索的知识库
@@ -58,14 +58,14 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
添加了多个知识库时,会同时检索所有知识库,合并结果并根据 [节点级检索设置](#调整节点级检索设置) 进行处理。
- 带有 **Vision** 图标的知识库支持跨模态检索:基于语义相关性同时检索文本和图片。
+ 带有 **Vision** 标签的知识库支持跨模态检索:按语义相关性同时返回文本和图片。
点击已添加知识库旁的 **编辑** 图标,可修改该知识库的 [设置](/zh/self-host/use-dify/knowledge/manage-knowledge/introduction)。
### 调整节点级检索设置
-设置节点在获取知识库检索结果后的处理方式。
+如需微调节点对检索结果的处理方式,点击 **召回设置**。
检索设置分为知识库级和节点级两层。
@@ -85,17 +85,17 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
- **Rerank 模型**
- 根据与查询内容的相关性,对所有结果的相似度分数进行重新评定和排序。
+ 该模型根据结果与查询内容的相关性,重新打分并排序。
- 若添加了多模态知识库,需同时选择多模态 Rerank 模型(带有 **Vision** 图标)。否则,检索到的图片将在重排序和最终输出中被排除。
+ 若添加了多模态知识库,还需选择多模态重排序模型(带有 **Vision** 标签)。否则,检索到的图片不会参与重排序,也不会出现在最终输出中。
- **Top K**
重排序后返回的最大结果数。
- 选择 Rerank 模型时,该值将根据模型的最大输入容量自动调整。
+ 选择重排序模型后,该值会根据模型的最大输入容量(即模型一次能处理的文本量)自动调整。
- **Score 阈值**
@@ -103,9 +103,9 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
### 启用元数据过滤
-可利用已有的文档元数据,将检索范围限定在知识库的特定文档内,以进一步提升检索精度。
+默认情况下,检索范围覆盖整个知识库。如需只检索特定文档,可启用手动或自动元数据过滤。
-启用元数据过滤后,知识检索节点仅会检索符合指定元数据过滤条件的文档,而非整个知识库。尤其适用于内容多样的大型知识库。
+启用后检索更精确,在知识库规模较大或内容涉及多种场景时尤其有效。
关于创建和管理文档元数据,详见 [元数据](/zh/self-host/use-dify/knowledge/metadata)。
@@ -117,14 +117,16 @@ description: 从知识库中检索相关内容,作为下游节点的上下文
## 搭配 LLM 节点使用知识检索节点
-如需在 LLM 节点中基于检索结果回答用户问题:
+如需在 LLM 节点中将检索结果用作上下文:
1. 在 **上下文** 字段中,选择知识检索节点的 `result` 变量。
-2. 在提示词字段中,同时引用 `上下文` 变量和用户输入变量(如 Chatflow 中的 `userinput.query`)。
+2. 在系统指令中引用 `上下文` 变量。
-3. (可选)若 LLM 支持视觉能力(带有 **Vision** 图标),可启用 **Vision**,以便其理解检索到的图片。
+3. (可选)若 LLM 支持视觉能力,可启用 **视觉**,处理检索结果中的图片附件。
- 启用 **Vision** 后,LLM 会自动处理检索到的图片。无需在 **Vision** 输入字段中再次手动引用 `上下文` 变量。
+ 无需将检索结果指定为视觉输入。启用 **视觉** 后,LLM 会自动获取检索到的所有图片。
+
+在 Chatflow 中,回复若引用了知识库内容,默认会一并显示引用来源。如不需要,可在画布右上角的 **功能** 中关闭 **[引用和归属](/zh/self-host/use-dify/build/additional-features#引用与归属)**。
diff --git a/zh/self-host/use-dify/workspace/api-extension/api-extension.mdx b/zh/self-host/use-dify/workspace/api-extension/api-extension.mdx
index 54afe74997..4ba5599cc5 100644
--- a/zh/self-host/use-dify/workspace/api-extension/api-extension.mdx
+++ b/zh/self-host/use-dify/workspace/api-extension/api-extension.mdx
@@ -7,20 +7,20 @@ sidebarTitle: 概述
开发者可通过自定义端点扩展模块能力,当前支持以下模块扩展:
-* `moderation` 敏感内容审计
+* `moderation` 敏感内容审核
* `external_data_tool` 外部数据工具
如需用自有服务扫描上传至知识库的文件,在 **集成** > **文件安全扫描** 中将其添加为 **自定义端点** 扫描服务。该服务会收到的请求详见 [自定义端点扫描服务 API](/zh/self-host/use-dify/knowledge/file-security-scan-custom-endpoint)。
-在扩展模块能力之前,你需要准备一个 API 和用于鉴权的 API Key。
+扩展模块能力前,你需要准备一个 API,以及用于鉴权的 API 密钥。
除了需要开发对应的模块能力,还需要遵照以下规范,以便 Dify 正确调用 API。
## API 规范
-Dify 将会以以下规范调用你的接口:
+Dify 按以下规范调用你的接口:
```
POST {Your-API-Endpoint}
@@ -31,7 +31,7 @@ POST {Your-API-Endpoint}
| Header | Value | Desc |
| --------------- | ----------------- | --------------------------------------------------------------------- |
| `Content-Type` | application/json | 请求内容为 JSON 格式。 |
-| `Authorization` | Bearer \{api_key\} | API Key 以 Token 令牌的方式传输,你需要解析该 `api_key` 并确认是否和提供的 API Key 一致,保证接口安全。 |
+| `Authorization` | Bearer \{api_key\} | API 密钥以令牌形式传输。为保证接口安全,你需要解析出 `api_key`,核对它与所提供的 API 密钥是否一致。 |
### Request Body
@@ -54,7 +54,7 @@ POST {Your-API-Endpoint}
## 校验
-在 Dify 配置自定义端点时,Dify 将会发送一个请求至 API Endpoint,以检验 API 的可用性。
+配置自定义端点时,Dify 会向 API Endpoint 发送一个请求,检验该 API 是否可用。
当 API Endpoint 接收到 `point=ping` 时,接口应返回 `result=pong`,具体如下:
@@ -194,16 +194,16 @@ Authorization: Bearer 123456
else:
return {"result": "Unknown city"}
```
-3. 启动 API 服务,默认端口为 8000,API 完整地址为:`http://127.0.0.1:8000/api/dify/receive`,配置的 API Key 为 `123456`。
+3. 启动 API 服务。默认端口为 8000,API 完整地址是 `http://127.0.0.1:8000/api/dify/receive`,配置的 API 密钥是 `123456`。
```
uvicorn main:app --reload --host 0.0.0.0
```
4. 在 Dify 配置该 API。
-5. 在 App 中选择该自定义端点。
+5. 在应用中选择该自定义端点。
-App 调试时,Dify 将请求配置的 API,并发送以下内容(范例):
+调试应用时,Dify 会请求已配置的 API,并发送以下内容(范例):
```
{
@@ -229,7 +229,7 @@ API 返回为:
## 本地调试
-如果自定义端点运行在你的本机,而 Dify 部署在别处,可使用 [Ngrok](https://ngrok.com) 将本地端点暴露到公网,让 Dify 实例能够访问。操作步骤:
+如果自定义端点运行在你的本机,而 Dify 部署在别处,可使用 [Ngrok](https://ngrok.com) 将本地端点暴露到公网,供 Dify 实例访问。操作步骤:
1. 进入 [https://ngrok.com](https://ngrok.com) 官网,注册并下载 Ngrok 文件。
@@ -260,14 +260,14 @@ API 返回为:

-4. 我们找到 Forwarding 中,如上图:`https://177e-159-223-41-52.ngrok-free.app`(此为示例域名,请替换为自己的)即为公网域名。
+4. 找到 Forwarding 一项对应的地址,即公网域名,如上图中的 `https://177e-159-223-41-52.ngrok-free.app`(此为示例域名,请替换为你自己的域名)。
-按照上述的范例,我们把本地已经启动的服务端点暴露出去,将代码范例接口:`http://127.0.0.1:8000/api/dify/receive` 替换为 `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive`
+沿用上面的范例:将本地已启动的服务端点暴露到公网后,把代码范例中的接口地址 `http://127.0.0.1:8000/api/dify/receive` 替换为 `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive`。
-此 API 端点即可公网访问。至此,我们即可在 Dify 配置该 API 端点进行本地调试代码,配置步骤请参考 [外部数据工具](/zh/self-host/use-dify/workspace/api-extension/external-data-tool-api-extension)。
+此 API 端点即可通过公网访问。现在可在 Dify 中配置该 API 端点来调试本地代码。配置步骤参见 [外部数据工具](/zh/self-host/use-dify/workspace/api-extension/external-data-tool-api-extension)。
## 使用 Cloudflare Workers 部署自定义端点
-我们推荐你使用 Cloudflare Workers 来部署你的自定义端点,因为 Cloudflare Workers 可以方便的提供一个公网地址,而且可以免费使用。
+推荐使用 Cloudflare Workers 部署自定义端点:它能便捷地提供公网地址,且可免费使用。
-详细说明请参考 [使用 Cloudflare Workers 部署自定义端点](/zh/self-host/use-dify/workspace/api-extension/cloudflare-worker)。
+详见 [使用 Cloudflare Workers 部署自定义端点](/zh/self-host/use-dify/workspace/api-extension/cloudflare-worker)。
From d74962cee2e825362c36bf516b0220c0c6e62e28 Mon Sep 17 00:00:00 2001
From: RiskeyL <7a8y@163.com>
Date: Fri, 20 Nov 2026 17:55:12 +0800
Subject: [PATCH 2/3] translate: fix older japanese wording on six knowledge
and extension pages
---
.../knowledge-base/create-knowledge-base.mdx | 6 ++--
.../import-text-data/readme.mdx | 15 +++++----
.../manage-knowledge/introduction.mdx | 8 ++---
.../use-dify/nodes/knowledge-retrieval.mdx | 32 ++++++++++---------
.../workspace/api-extension/api-extension.mdx | 32 +++++++++----------
.../import-text-data/readme.mdx | 14 ++++----
.../file-security-scan-custom-endpoint.mdx | 2 +-
.../manage-knowledge/introduction.mdx | 8 ++---
.../use-dify/nodes/knowledge-retrieval.mdx | 32 ++++++++++---------
.../workspace/api-extension/api-extension.mdx | 32 +++++++++----------
10 files changed, 93 insertions(+), 88 deletions(-)
diff --git a/ja/cloud/use-dify/knowledge-base/create-knowledge-base.mdx b/ja/cloud/use-dify/knowledge-base/create-knowledge-base.mdx
index a3fe25200f..f6ae70838e 100644
--- a/ja/cloud/use-dify/knowledge-base/create-knowledge-base.mdx
+++ b/ja/cloud/use-dify/knowledge-base/create-knowledge-base.mdx
@@ -24,14 +24,14 @@ description: Agent ナレッジベースを作成し、ソースやファイル
### ソースの接続 {#connect-a-source}
-ソースは、ウェブサイト、ドキュメントプラットフォーム、クラウドドライブからコンテンツを取り込みます。取り込みには、Firecrawl、Notion、Google Drive などのデータソース連携を使います。
+ソースは、ウェブサイト、ドキュメントプラットフォーム、クラウドドライブからコンテンツを取り込みます。取り込みには、Firecrawl、Notion、Google Drive などのデータソース統合を使います。
- ワークスペースにインストール済みのデータソース連携から選択します。**その他のプロバイダー** をクリックして、新しく探してインストールすることもできます。
+ ワークスペースにインストール済みのデータソース統合から選択します。**その他のプロバイダー** をクリックして、新しく探してインストールすることもできます。
- 必要な連携が見つからない場合は、[自分で開発する](/ja/develop-plugin/dev-guides-and-walkthroughs/datasource-plugin) か、コミュニティに [リクエスト](https://github.com/langgenius/dify-plugins/issues/new?template=plugin_request.yaml) してください。
+ 必要な統合が見つからない場合は、[自分で開発する](/ja/develop-plugin/dev-guides-and-walkthroughs/datasource-plugin) か、コミュニティに [リクエスト](https://github.com/langgenius/dify-plugins/issues/new?template=plugin_request.yaml) してください。
**連携** > **データソース** で API キーを入力するか、アカウントを認可して、接続を設定します。
diff --git a/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx b/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
index fc8baa6073..148b012448 100644
--- a/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
+++ b/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
@@ -1,5 +1,5 @@
---
-title: ローカルファイルをアップロード
+title: ローカルファイルのアップロード
---
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/cloud/use-dify/knowledge/create-knowledge/import-text-data/readme) を参照してください。
@@ -12,21 +12,22 @@ title: ローカルファイルをアップロード
1. **ナレッジ** > **作成** > **すぐに使えるナレッジベースを作成** をクリックします。
-2. データソースとして **既存テキストをインポート** を選択し、ファイルをアップロードします。
+2. データソースとして **テキストファイルからインポート** を選択し、ファイルをアップロードします。
-アップロードの上限はプランによって異なります([詳細](https://dify.ai/jp/pricing))。
+アップロードの上限はプランによって異なります。
| | Sandbox | Professional と Team |
|:--|:--|:--|
| 1 回あたりのファイル数 | 1 | 50 |
| 1 ファイルあたりのサイズ | 15 MB | 50 MB |
+
---
-**アップロードファイル内の画像について**
+**アップロードしたファイル内の画像**
JPG、JPEG、PNG、GIF 形式で 2MB 未満の画像は、該当するチャンクの添付ファイルとして自動抽出されます。これらの画像は個別に管理でき、検索時にチャンクと一緒に返されます。
- 抽出された画像の URL はチャンクテキスト内に残りますが、テキストをきれいに保つためにこれらの URL を安全に削除できます。削除しても抽出された画像には影響しません。
+ 抽出された画像の URL はチャンクテキスト内に残ります。テキストをすっきりさせたい場合は、これらの URL を削除しても問題ありません。抽出された画像には影響しません。
インデックス設定でマルチモーダル埋め込みモデル(**Vision** アイコン付き)を選択した場合、抽出された画像も埋め込まれ、検索用にインデックス化されます。
@@ -40,7 +41,7 @@ title: ローカルファイルをアップロード
その他のファイルタイプ(例:PDF)に埋め込まれた画像は、[ナレッジパイプライン](/ja/cloud/use-dify/knowledge/knowledge-pipeline/readme) で適切な文書抽出プラグインを使用して抽出できます。
- - 任意のファイルタイプで、以下の Markdown 記法でアクセス可能な URL を介して参照される画像:
+ - ファイルタイプを問わず、アクセス可能な URL を次の Markdown 記法で参照している画像:
- ``
- - ``
+ - ``
diff --git a/ja/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx b/ja/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
index 4e4f7e71f7..7121e090a2 100644
--- a/ja/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
+++ b/ja/cloud/use-dify/knowledge/manage-knowledge/introduction.mdx
@@ -6,7 +6,7 @@ sidebarTitle: 設定
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/cloud/use-dify/knowledge/manage-knowledge/introduction) を参照してください。
-ナレッジベースの設定を変更できるのは、ワークスペースの所有者、管理者、および編集者のみです。
+ナレッジベースの設定を変更できるのは、ワークスペースのオーナー、管理者、エディターのみです。
ナレッジベース内の左サイドバーにある **設定** アイコンをクリックして、ナレッジベースの設定ページに移動します。
@@ -15,8 +15,8 @@ sidebarTitle: 設定
|:---------------- |:-------------|
| 名前とアイコン | ナレッジベースを識別します。|
| 説明 | ナレッジベースの目的と内容を示します。|
-| 権限 | このナレッジベースへアクセスできるワークスペースメンバーを定義します。ナレッジベースへのアクセス権を付与されたメンバーは、[ナレッジコンテンツの管理](/ja/cloud/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) に記載されたすべての権限を持ちます。|
-| インデックス方法 | ドキュメントチャンクがどのように処理・整理され検索に使用されるかを定義します。詳細については、[インデックス方法の選択](/ja/cloud/use-dify/knowledge/create-knowledge/setting-indexing-methods#インデックス方法の選択) を参照してください。|
+| 権限 | このナレッジベースにアクセスできるワークスペースメンバーを設定します。ナレッジベースへのアクセス権を付与されたメンバーは、[ナレッジコンテンツの管理](/ja/cloud/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) に記載されたすべての権限を持ちます。|
+| インデックス方法 | ドキュメントチャンクを検索用にどう処理・整理するかを決めます。詳細については、[インデックス方法の選択](/ja/cloud/use-dify/knowledge/create-knowledge/setting-indexing-methods#インデックス方法の選択) を参照してください。|
| 埋め込みモデル | ドキュメントチャンクをベクトル表現に変換する際に使用する埋め込みモデルを指定します。埋め込みモデルを変更すると、すべてのチャンクが再度埋め込み処理されます。|
-| 要約の自動生成 | ドキュメントチャンクの要約を自動的に生成します。有効にすると、新しく追加されたドキュメントとチャンクにのみ適用されます。既存のチャンクについては、ドキュメントリストでドキュメントを選択し、**要約を生成** をクリックしてください。|
+| 要約自動生成 | ドキュメントチャンクの要約を自動的に生成します。有効にすると、新しく追加されたドキュメントとチャンクにのみ適用されます。既存のチャンクについては、ドキュメントリストでドキュメントを選択し、**要約を生成** をクリックしてください。|
| 検索設定 | ナレッジベースが関連するコンテンツをどのように検索するかを定義します。詳細については、[検索設定の構成](/ja/cloud/use-dify/knowledge/create-knowledge/setting-indexing-methods#検索設定の指定) を参照してください。|
diff --git a/ja/cloud/use-dify/nodes/knowledge-retrieval.mdx b/ja/cloud/use-dify/nodes/knowledge-retrieval.mdx
index d44d6b74d3..8eb34746c1 100644
--- a/ja/cloud/use-dify/nodes/knowledge-retrieval.mdx
+++ b/ja/cloud/use-dify/nodes/knowledge-retrieval.mdx
@@ -45,7 +45,7 @@ description: 従来型ナレッジベースから関連コンテンツを検索
### クエリの指定
-ノードが選択されたナレッジベースで検索するクエリ内容を指定します。
+選択したナレッジベースでノードに検索させるクエリを指定します。
- **クエリテキスト**:テキスト変数を選択します。たとえば、Chatflow では`userinput.query`を使用してユーザー入力を参照したり、Workflow ではカスタムのテキスト型ユーザー入力変数を使用したりできます。
@@ -54,24 +54,24 @@ description: 従来型ナレッジベースから関連コンテンツを検索
**クエリ画像** オプションは、少なくとも 1 つのマルチモーダルナレッジベースが追加されている場合のみ利用できます。
- そのようなナレッジベースには **Vision** アイコンが表示されており、マルチモーダル埋め込みモデルを使用していることを示しています。
+ こうしたナレッジベースには、マルチモーダル埋め込みモデルを使用していることを示す **Vision** タグが付いています。
### 検索対象ナレッジベースの選択
-ノードでクエリ内容に関連するコンテンツを検索するためのナレッジベースを 1 つ以上追加します。
+既存のナレッジベースを 1 つ以上追加します。ノードは、追加したナレッジベースからクエリに関連するコンテンツを検索します。
複数のナレッジベースを追加した場合、まずすべてのナレッジベースから同時に検索を行い、その後[ノードレベルの検索設定](#ノードレベルの検索設定)に従って結果を統合・処理します。
- **Vision** アイコンが付いたナレッジベースはクロスモーダル検索をサポートしており、セマンティックな関連性に基づいてテキストと画像の両方を検索できます。
+ **Vision** タグが付いたナレッジベースはクロスモーダル検索をサポートしており、セマンティックな関連性に基づいてテキストと画像の両方を検索できます。
追加したナレッジベースの横にある **編集** アイコンをクリックすると、その [設定](/ja/cloud/use-dify/knowledge/manage-knowledge/introduction) を変更できます。
### ノードレベルの検索設定
-ナレッジベースから取得した検索結果を、ノード内でどのように処理するかを微調整できます。
+ナレッジベースから取得した検索結果をノードでどう処理するかを細かく調整するには、**検索設定** をクリックします。
検索設定には、ナレッジベースレベルと知識検索ノードレベルという 2 つのレイヤーがあります。
@@ -91,27 +91,27 @@ description: 従来型ナレッジベースから関連コンテンツを検索
- **Rerank モデル**
- クエリとの関連度に基づいてすべての結果を再スコアリング・並べ替えする Rerank モデルです。
+ クエリとの関連度に基づいてすべての結果を再スコアリング・並べ替えるリランクモデルです。
- マルチモーダルナレッジベースが追加されている場合は、マルチモーダル Rerank モデル(**Vision** アイコン付き)も選択してください。そうでない場合、検索された画像は再ランク付けおよび最終出力から除外されます。
+ マルチモーダルナレッジベースを追加している場合は、マルチモーダル対応のリランクモデル(**Vision** タグ付き)も選択してください。選択しないと、検索された画像は再ランク付けの対象外となり、最終出力にも含まれません。
- **トップ K**
再ランク後に返す結果の最大件数です。
- Rerank モデルを選択している場合、この値はモデルの最大入力容量(モデルが一度に処理できるテキスト量)に基づいて自動的に調整されます。
+ リランクモデルを選択している場合、この値はモデルの最大入力容量(モデルが一度に処理できるテキスト量)に応じて自動的に調整されます。
- **スコア閾値**
- 返される結果の最低類似度スコアです。この閾値未満の結果は除外されます。高めに設定すると関連性の厳密な検索が行われ、低めにするとより広範なマッチを含めることができます。
+ 返される結果の最低類似度スコアです。この閾値未満の結果は除外されます。関連性を厳しく判定するには高めに、より幅広い結果を含めるには低めに設定します。
### メタデータフィルタの有効化
-既存のドキュメントメタデータを使用して、ナレッジベース内の特定のドキュメントに検索を制限し、検索精度を向上させます。
+デフォルトでは、ナレッジベース全体を検索します。特定のドキュメントに絞って検索するには、手動または自動のメタデータフィルタを有効にします。
-メタデータフィルタを有効にすると、知識検索ノードはナレッジベース全体を検索するのではなく、指定されたメタデータ条件に一致するドキュメントのみを検索します。これは、大規模で多様なナレッジベースでのターゲット検索に特に有用です。
+これにより検索精度が上がります。ナレッジベースが大きい場合や、用途の異なるコンテンツが混在している場合に特に効果的です。
ドキュメントメタデータの作成と管理については、[メタデータ](/ja/cloud/use-dify/knowledge/metadata) を参照してください。
@@ -123,14 +123,16 @@ description: 従来型ナレッジベースから関連コンテンツを検索
## LLM ノードとの連携
-LLM ノードでユーザーの質問に回答するためのコンテキストとして検索結果を使用するには:
+LLM ノードで検索結果をコンテキストとして使うには、次のように設定します。
1. **コンテキスト** フィールドで、知識検索ノードの`result`変数を選択します。
-2. プロンプトフィールドで、`Context`変数とユーザー入力変数(例:Chatflow の`userinput.query`)の両方を参照します。
+2. システムインストラクションで `Context` 変数を参照します。
-3. (任意)LLM が Vision 機能に対応している場合(**Vision** アイコン付き)、**Vision** を有効にして検索された画像を解釈させることができます。
+3. (任意)LLM がビジョンに対応している場合は、**ビジョン** を有効にして、検索結果に含まれる画像添付を処理できるようにします。
- **Vision** を有効にすると、LLM は検索された画像を自動的に処理します。**Vision** 入力フィールドで`Context`変数を再度手動で参照する必要はありません。
+ 検索結果をビジョン入力として指定する必要はありません。**ビジョン** を有効にすると、LLM は検索された画像を自動的に参照します。
+
+Chatflow では、ナレッジを参照する応答にデフォルトで引用が表示されます。オフにするには、キャンバス右上の **機能** で **[引用と帰属](/ja/cloud/use-dify/build/additional-features#引用と帰属)** を無効にします。
diff --git a/ja/cloud/use-dify/workspace/api-extension/api-extension.mdx b/ja/cloud/use-dify/workspace/api-extension/api-extension.mdx
index 91c32a13a6..2167ba2c01 100644
--- a/ja/cloud/use-dify/workspace/api-extension/api-extension.mdx
+++ b/ja/cloud/use-dify/workspace/api-extension/api-extension.mdx
@@ -5,14 +5,14 @@ sidebarTitle: 概要
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/cloud/use-dify/workspace/api-extension/api-extension) を参照してください。
-開発者はカスタム API モジュール機能を使用してモジュール機能を拡張できます。現在、以下のモジュール拡張がサポートされています:
+カスタム API を使うと、モジュールの機能を拡張できます。現在対応している拡張タイプは次のとおりです。
* `moderation` センシティブコンテンツ審査
* `external_data_tool` 外部データツール
-モジュール機能を拡張する前に、API と認証用の API Key を準備する必要があります。
+モジュールの機能を拡張する前に、API と認証用の API キーを用意してください。
-対応するモジュール機能を開発する必要があるだけでなく、Dify が API を正しく呼び出せるように、以下の仕様に従う必要があります。
+対応するモジュール機能の開発に加えて、Dify が API を正しく呼び出せるよう、以下の仕様にも従ってください。
## API 仕様
@@ -27,13 +27,13 @@ POST {Your-API-Endpoint}
| Header | Value | Desc |
| --------------- | ----------------- | --------------------------------------------------------------------- |
| `Content-Type` | application/json | リクエストコンテンツは JSON 形式です。 |
-| `Authorization` | Bearer \{api_key\} | API Key はトークン形式で送信されます。この `api_key` を解析し、提供された API Key と一致することを確認して、インターフェースのセキュリティを確保する必要があります。 |
+| `Authorization` | Bearer \{api_key\} | API キーはトークン形式で送信されます。インターフェースのセキュリティを確保するため、この `api_key` を解析し、提供された API キーと一致するか確認してください。 |
### Request Body
```
{
- "point": string, // 拡張ポイント、異なるモジュールには複数の拡張ポイントが含まれる場合があります
+ "point": string, // 拡張ポイント(モジュールによっては複数あります)
"params": {
... // 各モジュール拡張ポイントに渡されるパラメータ
}
@@ -44,15 +44,15 @@ POST {Your-API-Endpoint}
```
{
- ... // API が返すコンテンツ、異なる拡張ポイントのレスポンスについては各モジュールの仕様設計を参照してください
+ ... // API が返す内容。拡張ポイントごとのレスポンスは、各モジュールの仕様を参照してください
}
```
## 検証
-Dify でカスタム API を設定する際、Dify は API の可用性を確認するために API Endpoint にリクエストを送信します。
+カスタム API を設定すると、Dify は API エンドポイントにリクエストを送り、API が利用できるかどうかを確認します。
-API Endpoint が `point=ping` を受信したとき、インターフェースは `result=pong` を返す必要があります。具体的には以下の通りです:
+API エンドポイントは `point=ping` を受信したら、次のように `result=pong` を返す必要があります。
### Header
@@ -191,16 +191,16 @@ Authorization: Bearer 123456
else:
return {"result": "Unknown city"}
```
-3. API サービスを起動します。デフォルトポートは 8000 で、完全な API アドレスは `http://127.0.0.1:8000/api/dify/receive`、設定された API Key は `123456` です。
+3. API サービスを起動します。デフォルトポートは 8000 で、完全な API アドレスは `http://127.0.0.1:8000/api/dify/receive`、設定した API キーは `123456` です。
```
uvicorn main:app --reload --host 0.0.0.0
```
4. Dify でこの API を設定します。
-5. App でこのカスタム API を選択します。
+5. アプリでこのカスタム API を選択します。
-App のデバッグ時、Dify は設定された API にリクエストを送信し、以下の内容を送信します(サンプル):
+アプリをデバッグすると、Dify は設定した API に次のような内容を送信します。
```
{
@@ -216,7 +216,7 @@ App のデバッグ時、Dify は設定された API にリクエストを送信
}
```
-API レスポンスは:
+API は次のレスポンスを返します。
```
{
@@ -226,7 +226,7 @@ API レスポンスは:
## ローカルデバッグ
-Dify はプライベートネットワーク上の API サービスにアクセスできないため、ローカルで API サービスをデバッグするには、[Ngrok](https://ngrok.com) を使用して API サービスのエンドポイントを公開ネットワークに公開し、クラウドでローカルコードをデバッグできるようにします。操作手順:
+Dify からはプライベートネットワーク上の API サービスにアクセスできません。[Ngrok](https://ngrok.com) で API サービスのエンドポイントをインターネットに公開すれば、ローカルのコードをクラウドからデバッグできます。手順は次のとおりです。
1. [https://ngrok.com](https://ngrok.com) の公式サイトにアクセスし、登録して Ngrok ファイルをダウンロードします。
@@ -237,7 +237,7 @@ Dify はプライベートネットワーク上の API サービスにアクセ
2. ダウンロード完了後、ダウンロードディレクトリに移動し、以下の説明に従って圧縮ファイルを解凍し、説明の初期化スクリプトを実行します。
```shell
unzip /path/to/ngrok.zip
- ./ngrok config add-authtoken あなたの Token
+ ./ngrok config add-authtoken トークン
```
3. ローカル API サービスのポートを確認します:
@@ -257,9 +257,9 @@ Dify はプライベートネットワーク上の API サービスにアクセ

-4. Forwarding の中から、上図のように `https://177e-159-223-41-52.ngrok-free.app`(これはサンプルドメインです、自分のものに置き換えてください)が公開ネットワークドメインです。
+4. 上図のように、Forwarding のアドレスを確認します。この例では `https://177e-159-223-41-52.ngrok-free.app` が公開ドメインです。実際には自分のドメインに置き換えてください。
-上記のサンプルに従って、ローカルで既に起動されているサービスエンドポイントを公開し、コードサンプルのインターフェース `http://127.0.0.1:8000/api/dify/receive` を `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive` に置き換えます。
+上の例に沿って、ローカルで起動したサービスのエンドポイントを公開し、コード例のインターフェース `http://127.0.0.1:8000/api/dify/receive` を `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive` に置き換えます。
この API エンドポイントは公開ネットワークでアクセス可能になります。これで、Dify でこの API エンドポイントを設定してローカルコードをデバッグできます。設定手順については、[外部データツール](/ja/cloud/use-dify/workspace/api-extension/external-data-tool-api-extension) を参照してください。
diff --git a/ja/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx b/ja/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
index 1c0b15e634..b230501d15 100644
--- a/ja/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
+++ b/ja/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme.mdx
@@ -1,5 +1,5 @@
---
-title: ローカルファイルをアップロード
+title: ローカルファイルのアップロード
---
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/self-host/use-dify/knowledge/create-knowledge/import-text-data/readme) を参照してください。
@@ -12,7 +12,7 @@ title: ローカルファイルをアップロード
1. **ナレッジ** > **作成** > **すぐに使えるナレッジベースを作成** をクリックします。
-2. データソースとして **既存テキストをインポート** を選択し、ファイルをアップロードします。
+2. データソースとして **テキストファイルからインポート** を選択し、ファイルをアップロードします。
- 1 回のアップロードで選択できるファイル数の上限:5(`UPLOAD_FILE_BATCH_LIMIT` で設定)
@@ -20,15 +20,15 @@ title: ローカルファイルをアップロード
---
-**アップロードファイル内の画像について**
+**アップロードしたファイル内の画像**
JPG、JPEG、PNG、GIF 形式で 2MB 未満の画像は、該当するチャンクの添付ファイルとして自動抽出されます。これらの画像は個別に管理でき、検索時にチャンクと一緒に返されます。
- 抽出された画像の URL はチャンクテキスト内に残りますが、テキストをきれいに保つためにこれらの URL を安全に削除できます。削除しても抽出された画像には影響しません。
+ 抽出された画像の URL はチャンクテキスト内に残ります。テキストをすっきりさせたい場合は、これらの URL を削除しても問題ありません。抽出された画像には影響しません。
インデックス設定でマルチモーダル埋め込みモデル(**Vision** アイコン付き)を選択した場合、抽出された画像も埋め込まれ、検索用にインデックス化されます。
- 1 チャンクにつき最大 10 枚まで画像添付が可能です(`SINGLE_CHUNK_ATTACHMENT_LIMIT` で設定)。超過分は抽出されません。画像サイズの上限は `ATTACHMENT_IMAGE_FILE_SIZE_LIMIT` で制御されます。
+ 1 チャンクにつき最大 10 枚まで画像添付が可能です(`SINGLE_CHUNK_ATTACHMENT_LIMIT` で設定)。超過分は抽出されません。画像サイズの上限は `ATTACHMENT_IMAGE_FILE_SIZE_LIMIT` で設定します。
上記の抽出ルールの対象:
@@ -38,7 +38,7 @@ title: ローカルファイルをアップロード
その他のファイルタイプ(例:PDF)に埋め込まれた画像は、[ナレッジパイプライン](/ja/self-host/use-dify/knowledge/knowledge-pipeline/readme) で適切な文書抽出プラグインを使用して抽出できます。
- - 任意のファイルタイプで、以下の Markdown 記法でアクセス可能な URL を介して参照される画像:
+ - ファイルタイプを問わず、アクセス可能な URL を次の Markdown 記法で参照している画像:
- ``
- - ``
+ - ``
diff --git a/ja/self-host/use-dify/knowledge/file-security-scan-custom-endpoint.mdx b/ja/self-host/use-dify/knowledge/file-security-scan-custom-endpoint.mdx
index 26b35399ef..e53605f924 100644
--- a/ja/self-host/use-dify/knowledge/file-security-scan-custom-endpoint.mdx
+++ b/ja/self-host/use-dify/knowledge/file-security-scan-custom-endpoint.mdx
@@ -6,7 +6,7 @@ description: Dify がナレッジベースのアップロードファイルを
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/self-host/use-dify/knowledge/file-security-scan-custom-endpoint) を参照してください。
-**カスタム API** スキャナーでスキャンするナレッジベースでは、アップロードされたファイルを Dify が自社のスキャンサービスに送信します。その後、サービスが返した判定結果に従って処理します。問題のないファイルは通常どおりインデックス化され、感染したファイルはブロックされます。
+**カスタム API** スキャナーでスキャンするナレッジベースでは、アップロードされたファイルを Dify が自社のスキャンサービスに送信します。その後、Dify はサービスが返した判定結果に従ってファイルを処理します。問題のないファイルは通常どおりインデックス化され、感染したファイルはブロックされます。
エンドポイントが稼働したら、**連携** > **ファイルセキュリティスキャン** > **スキャナーを追加** > **カスタム API** で追加します。ナレッジベースでスキャンを有効にする方法は、[アップロードされたファイルのマルウェアスキャン](/ja/self-host/use-dify/knowledge/file-security-scan) を参照してください。
diff --git a/ja/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx b/ja/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
index a825568ada..ad0f6d466d 100644
--- a/ja/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
+++ b/ja/self-host/use-dify/knowledge/manage-knowledge/introduction.mdx
@@ -6,7 +6,7 @@ sidebarTitle: 設定
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/self-host/use-dify/knowledge/manage-knowledge/introduction) を参照してください。
-ナレッジベースの設定を変更できるのは、ワークスペースの所有者、管理者、および編集者のみです。
+ナレッジベースの設定を変更できるのは、ワークスペースのオーナー、管理者、エディターのみです。
ナレッジベース内の左サイドバーにある **設定** アイコンをクリックして、ナレッジベースの設定ページに移動します。
@@ -15,9 +15,9 @@ sidebarTitle: 設定
|:---------------- |:-------------|
| 名前とアイコン | ナレッジベースを識別します。|
| 説明 | ナレッジベースの目的と内容を示します。|
-| 権限 | このナレッジベースへアクセスできるワークスペースメンバーを定義します。ナレッジベースへのアクセス権を付与されたメンバーは、[ナレッジコンテンツの管理](/ja/self-host/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) に記載されたすべての権限を持ちます。|
-| インデックス方法 | ドキュメントチャンクがどのように処理・整理され検索に使用されるかを定義します。詳細については、[インデックス方法の選択](/ja/self-host/use-dify/knowledge/create-knowledge/setting-indexing-methods#インデックス方法の選択) を参照してください。|
+| 権限 | このナレッジベースにアクセスできるワークスペースメンバーを設定します。ナレッジベースへのアクセス権を付与されたメンバーは、[ナレッジコンテンツの管理](/ja/self-host/use-dify/knowledge/manage-knowledge/maintain-knowledge-documents) に記載されたすべての権限を持ちます。|
+| インデックス方法 | ドキュメントチャンクを検索用にどう処理・整理するかを決めます。詳細については、[インデックス方法の選択](/ja/self-host/use-dify/knowledge/create-knowledge/setting-indexing-methods#インデックス方法の選択) を参照してください。|
| 埋め込みモデル | ドキュメントチャンクをベクトル表現に変換する際に使用する埋め込みモデルを指定します。埋め込みモデルを変更すると、すべてのチャンクが再度埋め込み処理されます。|
-| 要約の自動生成 | ドキュメントチャンクの要約を自動的に生成します。有効にすると、新しく追加されたドキュメントとチャンクにのみ適用されます。既存のチャンクについては、ドキュメントリストでドキュメントを選択し、**要約を生成** をクリックしてください。|
+| 要約自動生成 | ドキュメントチャンクの要約を自動的に生成します。有効にすると、新しく追加されたドキュメントとチャンクにのみ適用されます。既存のチャンクについては、ドキュメントリストでドキュメントを選択し、**要約を生成** をクリックしてください。|
| 検索設定 | ナレッジベースが関連するコンテンツをどのように検索するかを定義します。詳細については、[検索設定の構成](/ja/self-host/use-dify/knowledge/create-knowledge/setting-indexing-methods#検索設定の指定) を参照してください。|
| ファイルセキュリティスキャン | 新しくアップロードされたファイルを、インデックス化の前にマルウェアスキャンします。デプロイ環境で有効にした場合にのみ表示されます。設定方法と選択肢については、[アップロードされたファイルのマルウェアスキャン](/ja/self-host/use-dify/knowledge/file-security-scan) を参照してください。|
diff --git a/ja/self-host/use-dify/nodes/knowledge-retrieval.mdx b/ja/self-host/use-dify/nodes/knowledge-retrieval.mdx
index 8a8cb313be..4a3594c3c7 100644
--- a/ja/self-host/use-dify/nodes/knowledge-retrieval.mdx
+++ b/ja/self-host/use-dify/nodes/knowledge-retrieval.mdx
@@ -37,7 +37,7 @@ description: ナレッジベースから関連コンテンツを検索し、下
### クエリの指定
-ノードが選択されたナレッジベースで検索するクエリ内容を指定します。
+選択したナレッジベースでノードに検索させるクエリを指定します。
- **クエリテキスト**:テキスト変数を選択します。たとえば、Chatflow では`userinput.query`を使用してユーザー入力を参照したり、Workflow ではカスタムのテキスト型ユーザー入力変数を使用したりできます。
@@ -48,24 +48,24 @@ description: ナレッジベースから関連コンテンツを検索し、下
**クエリ画像** オプションは、少なくとも 1 つのマルチモーダルナレッジベースが追加されている場合のみ利用できます。
- そのようなナレッジベースには **Vision** アイコンが表示されており、マルチモーダル埋め込みモデルを使用していることを示しています。
+ こうしたナレッジベースには、マルチモーダル埋め込みモデルを使用していることを示す **Vision** タグが付いています。
### 検索対象ナレッジベースの選択
-ノードでクエリ内容に関連するコンテンツを検索するためのナレッジベースを 1 つ以上追加します。
+既存のナレッジベースを 1 つ以上追加します。ノードは、追加したナレッジベースからクエリに関連するコンテンツを検索します。
複数のナレッジベースを追加した場合、まずすべてのナレッジベースから同時に検索を行い、その後[ノードレベルの検索設定](#ノードレベルの検索設定)に従って結果を統合・処理します。
- **Vision** アイコンが付いたナレッジベースはクロスモーダル検索をサポートしており、セマンティックな関連性に基づいてテキストと画像の両方を検索できます。
+ **Vision** タグが付いたナレッジベースはクロスモーダル検索をサポートしており、セマンティックな関連性に基づいてテキストと画像の両方を検索できます。
追加したナレッジベースの横にある **編集** アイコンをクリックすると、その [設定](/ja/self-host/use-dify/knowledge/manage-knowledge/introduction) を変更できます。
### ノードレベルの検索設定
-ナレッジベースから取得した検索結果を、ノード内でどのように処理するかを微調整できます。
+ナレッジベースから取得した検索結果をノードでどう処理するかを細かく調整するには、**検索設定** をクリックします。
検索設定には、ナレッジベースレベルと知識検索ノードレベルという 2 つのレイヤーがあります。
@@ -85,27 +85,27 @@ description: ナレッジベースから関連コンテンツを検索し、下
- **Rerank モデル**
- クエリとの関連度に基づいてすべての結果を再スコアリング・並べ替えする Rerank モデルです。
+ クエリとの関連度に基づいてすべての結果を再スコアリング・並べ替えるリランクモデルです。
- マルチモーダルナレッジベースが追加されている場合は、マルチモーダル Rerank モデル(**Vision** アイコン付き)も選択してください。そうでない場合、検索された画像は再ランク付けおよび最終出力から除外されます。
+ マルチモーダルナレッジベースを追加している場合は、マルチモーダル対応のリランクモデル(**Vision** タグ付き)も選択してください。選択しないと、検索された画像は再ランク付けの対象外となり、最終出力にも含まれません。
- **トップ K**
再ランク後に返す結果の最大件数です。
- Rerank モデルを選択している場合、この値はモデルの最大入力容量(モデルが一度に処理できるテキスト量)に基づいて自動的に調整されます。
+ リランクモデルを選択している場合、この値はモデルの最大入力容量(モデルが一度に処理できるテキスト量)に応じて自動的に調整されます。
- **スコア閾値**
- 返される結果の最低類似度スコアです。この閾値未満の結果は除外されます。高めに設定すると関連性の厳密な検索が行われ、低めにするとより広範なマッチを含めることができます。
+ 返される結果の最低類似度スコアです。この閾値未満の結果は除外されます。関連性を厳しく判定するには高めに、より幅広い結果を含めるには低めに設定します。
### メタデータフィルタの有効化
-既存のドキュメントメタデータを使用して、ナレッジベース内の特定のドキュメントに検索を制限し、検索精度を向上させます。
+デフォルトでは、ナレッジベース全体を検索します。特定のドキュメントに絞って検索するには、手動または自動のメタデータフィルタを有効にします。
-メタデータフィルタを有効にすると、知識検索ノードはナレッジベース全体を検索するのではなく、指定されたメタデータ条件に一致するドキュメントのみを検索します。これは、大規模で多様なナレッジベースでのターゲット検索に特に有用です。
+これにより検索精度が上がります。ナレッジベースが大きい場合や、用途の異なるコンテンツが混在している場合に特に効果的です。
ドキュメントメタデータの作成と管理については、[メタデータ](/ja/self-host/use-dify/knowledge/metadata) を参照してください。
@@ -117,14 +117,16 @@ description: ナレッジベースから関連コンテンツを検索し、下
## LLM ノードとの連携
-LLM ノードでユーザーの質問に回答するためのコンテキストとして検索結果を使用するには:
+LLM ノードで検索結果をコンテキストとして使うには、次のように設定します。
1. **コンテキスト** フィールドで、知識検索ノードの`result`変数を選択します。
-2. プロンプトフィールドで、`Context`変数とユーザー入力変数(例:Chatflow の`userinput.query`)の両方を参照します。
+2. システムインストラクションで `Context` 変数を参照します。
-3. (任意)LLM が Vision 機能に対応している場合(**Vision** アイコン付き)、**Vision** を有効にして検索された画像を解釈させることができます。
+3. (任意)LLM がビジョンに対応している場合は、**ビジョン** を有効にして、検索結果に含まれる画像添付を処理できるようにします。
- **Vision** を有効にすると、LLM は検索された画像を自動的に処理します。**Vision** 入力フィールドで`Context`変数を再度手動で参照する必要はありません。
+ 検索結果をビジョン入力として指定する必要はありません。**ビジョン** を有効にすると、LLM は検索された画像を自動的に参照します。
+
+Chatflow では、ナレッジを参照する応答にデフォルトで引用が表示されます。オフにするには、キャンバス右上の **機能** で **[引用と帰属](/ja/self-host/use-dify/build/additional-features#引用と帰属)** を無効にします。
diff --git a/ja/self-host/use-dify/workspace/api-extension/api-extension.mdx b/ja/self-host/use-dify/workspace/api-extension/api-extension.mdx
index 6abb617f39..2b18a407cd 100644
--- a/ja/self-host/use-dify/workspace/api-extension/api-extension.mdx
+++ b/ja/self-host/use-dify/workspace/api-extension/api-extension.mdx
@@ -5,7 +5,7 @@ sidebarTitle: 概要
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/self-host/use-dify/workspace/api-extension/api-extension) を参照してください。
-開発者はカスタム API モジュール機能を使用してモジュール機能を拡張できます。現在、以下のモジュール拡張がサポートされています:
+カスタム API を使うと、モジュールの機能を拡張できます。現在対応している拡張タイプは次のとおりです。
* `moderation` センシティブコンテンツ審査
* `external_data_tool` 外部データツール
@@ -14,9 +14,9 @@ sidebarTitle: 概要
ナレッジベースにアップロードされたファイルは、自社のサービスでもスキャンできます。その場合は、**連携** > **ファイルセキュリティスキャン** で **カスタム API** スキャナーとして追加します。サービスが受け取るリクエストについては、[カスタム API スキャナーの仕様](/ja/self-host/use-dify/knowledge/file-security-scan-custom-endpoint) を参照してください。
-モジュール機能を拡張する前に、API と認証用の API Key を準備する必要があります。
+モジュールの機能を拡張する前に、API と認証用の API キーを用意してください。
-対応するモジュール機能を開発する必要があるだけでなく、Dify が API を正しく呼び出せるように、以下の仕様に従う必要があります。
+対応するモジュール機能の開発に加えて、Dify が API を正しく呼び出せるよう、以下の仕様にも従ってください。
## API 仕様
@@ -31,13 +31,13 @@ POST {Your-API-Endpoint}
| Header | Value | Desc |
| --------------- | ----------------- | --------------------------------------------------------------------- |
| `Content-Type` | application/json | リクエストコンテンツは JSON 形式です。 |
-| `Authorization` | Bearer \{api_key\} | API Key はトークン形式で送信されます。この `api_key` を解析し、提供された API Key と一致することを確認して、インターフェースのセキュリティを確保する必要があります。 |
+| `Authorization` | Bearer \{api_key\} | API キーはトークン形式で送信されます。インターフェースのセキュリティを確保するため、この `api_key` を解析し、提供された API キーと一致するか確認してください。 |
### Request Body
```
{
- "point": string, // 拡張ポイント、異なるモジュールには複数の拡張ポイントが含まれる場合があります
+ "point": string, // 拡張ポイント(モジュールによっては複数あります)
"params": {
... // 各モジュール拡張ポイントに渡されるパラメータ
}
@@ -48,15 +48,15 @@ POST {Your-API-Endpoint}
```
{
- ... // API が返すコンテンツ、異なる拡張ポイントのレスポンスについては各モジュールの仕様設計を参照してください
+ ... // API が返す内容。拡張ポイントごとのレスポンスは、各モジュールの仕様を参照してください
}
```
## 検証
-Dify でカスタム API を設定する際、Dify は API の可用性を確認するために API Endpoint にリクエストを送信します。
+カスタム API を設定すると、Dify は API エンドポイントにリクエストを送り、API が利用できるかどうかを確認します。
-API Endpoint が `point=ping` を受信したとき、インターフェースは `result=pong` を返す必要があります。具体的には以下の通りです:
+API エンドポイントは `point=ping` を受信したら、次のように `result=pong` を返す必要があります。
### Header
@@ -195,16 +195,16 @@ Authorization: Bearer 123456
else:
return {"result": "Unknown city"}
```
-3. API サービスを起動します。デフォルトポートは 8000 で、完全な API アドレスは `http://127.0.0.1:8000/api/dify/receive`、設定された API Key は `123456` です。
+3. API サービスを起動します。デフォルトポートは 8000 で、完全な API アドレスは `http://127.0.0.1:8000/api/dify/receive`、設定した API キーは `123456` です。
```
uvicorn main:app --reload --host 0.0.0.0
```
4. Dify でこの API を設定します。
-5. App でこのカスタム API を選択します。
+5. アプリでこのカスタム API を選択します。
-App のデバッグ時、Dify は設定された API にリクエストを送信し、以下の内容を送信します(サンプル):
+アプリをデバッグすると、Dify は設定した API に次のような内容を送信します。
```
{
@@ -220,7 +220,7 @@ App のデバッグ時、Dify は設定された API にリクエストを送信
}
```
-API レスポンスは:
+API は次のレスポンスを返します。
```
{
@@ -230,7 +230,7 @@ API レスポンスは:
## ローカルデバッグ
-Dify を別の場所にデプロイしたまま、ローカルマシンで動作するカスタム API をデバッグするには、[Ngrok](https://ngrok.com) を使用してローカルエンドポイントを公開インターネットに公開し、Dify インスタンスから到達できるようにします。操作手順:
+ローカルマシンで動かしているカスタム API を、別の環境にデプロイした Dify からデバッグするには、[Ngrok](https://ngrok.com) を使います。ローカルのエンドポイントをインターネットに公開すれば、Dify インスタンスからアクセスできるようになります。手順は次のとおりです。
1. [https://ngrok.com](https://ngrok.com) の公式サイトにアクセスし、登録して Ngrok ファイルをダウンロードします。
@@ -241,7 +241,7 @@ Dify を別の場所にデプロイしたまま、ローカルマシンで動作
2. ダウンロード完了後、ダウンロードディレクトリに移動し、以下の説明に従って圧縮ファイルを解凍し、説明の初期化スクリプトを実行します。
```shell
unzip /path/to/ngrok.zip
- ./ngrok config add-authtoken あなたの Token
+ ./ngrok config add-authtoken トークン
```
3. ローカル API サービスのポートを確認します:
@@ -261,9 +261,9 @@ Dify を別の場所にデプロイしたまま、ローカルマシンで動作

-4. Forwarding の中から、上図のように `https://177e-159-223-41-52.ngrok-free.app`(これはサンプルドメインです、自分のものに置き換えてください)が公開ネットワークドメインです。
+4. 上図のように、Forwarding のアドレスを確認します。この例では `https://177e-159-223-41-52.ngrok-free.app` が公開ドメインです。実際には自分のドメインに置き換えてください。
-上記のサンプルに従って、ローカルで既に起動されているサービスエンドポイントを公開し、コードサンプルのインターフェース `http://127.0.0.1:8000/api/dify/receive` を `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive` に置き換えます。
+上の例に沿って、ローカルで起動したサービスのエンドポイントを公開し、コード例のインターフェース `http://127.0.0.1:8000/api/dify/receive` を `https://177e-159-223-41-52.ngrok-free.app/api/dify/receive` に置き換えます。
この API エンドポイントは公開ネットワークでアクセス可能になります。これで、Dify でこの API エンドポイントを設定してローカルコードをデバッグできます。設定手順については、[外部データツール](/ja/self-host/use-dify/workspace/api-extension/external-data-tool-api-extension) を参照してください。
From 90be40a0f5b512823fe48eb50399ab7b018b7f1c Mon Sep 17 00:00:00 2001
From: RiskeyL <7a8y@163.com>
Date: Fri, 20 Nov 2026 17:55:12 +0800
Subject: [PATCH 3/3] =?UTF-8?q?translate:=20rename=20the=20japanese=20comp?=
=?UTF-8?q?letion=20endpoints=20to=20=E3=83=86=E3=82=AD=E3=82=B9=E3=83=88?=
=?UTF-8?q?=E7=94=9F=E6=88=90?=
MIME-Version: 1.0
Content-Type: text/plain; charset=UTF-8
Content-Transfer-Encoding: 8bit
---
docs.json | 4 ++--
ja/api-reference/guides/completion.mdx | 8 ++++----
ja/api-reference/guides/streaming.mdx | 2 +-
ja/api-reference/openapi_service.json | 22 +++++++++++-----------
4 files changed, 18 insertions(+), 18 deletions(-)
diff --git a/docs.json b/docs.json
index 2293fab966..3624bb5bc1 100644
--- a/docs.json
+++ b/docs.json
@@ -3730,7 +3730,7 @@
]
},
{
- "group": "完了メッセージ",
+ "group": "テキスト生成メッセージ",
"openapi": "ja/api-reference/openapi_service.json",
"pages": [
"POST /completion-messages",
@@ -4590,7 +4590,7 @@
]
},
{
- "group": "完了メッセージ",
+ "group": "テキスト生成メッセージ",
"openapi": "ja/api-reference/openapi_service.json",
"pages": [
"POST /completion-messages",
diff --git a/ja/api-reference/guides/completion.mdx b/ja/api-reference/guides/completion.mdx
index 55734cffde..6b1de86eb2 100644
--- a/ja/api-reference/guides/completion.mdx
+++ b/ja/api-reference/guides/completion.mdx
@@ -1,7 +1,7 @@
---
title: テキストジェネレーターアプリ API
sidebarTitle: テキストジェネレーター
-description: 完了メッセージ、ファイルアップロード、音声変換、フィードバックを扱うテキストジェネレーターアプリ向けの API
+description: テキスト生成メッセージ、ファイルアップロード、音声変換、フィードバックを扱うテキストジェネレーターアプリ向けの API
---
> このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、[英語版](/en/api-reference/guides/completion) を参照してください。
@@ -14,12 +14,12 @@ description: 完了メッセージ、ファイルアップロード、音声変
## テキストの生成
-- **[完了メッセージを送信](/ja/api-reference/completion-messages/send-completion-message)**:`inputs` の値をアプリのプロンプトテンプレートに反映し、応答を生成します。ブロッキングモードでは生成の完了後に応答をまとめて返します。ストリーミングモードでは `message` イベントを `message_end` まで連続で受信できます。アプリでテキスト読み上げの自動再生が有効な場合は、`tts_message` イベントも届きます。
-- **[完了メッセージの生成を停止](/ja/api-reference/completion-messages/stop-completion-message-generation)**:ストリーミング中の応答を完了前に中断します。
+- **[テキスト生成メッセージを送信](/ja/api-reference/completion-messages/send-completion-message)**:`inputs` の値をアプリのプロンプトテンプレートに反映し、応答を生成します。ブロッキングモードでは生成の完了後に応答をまとめて返します。ストリーミングモードでは `message` イベントを `message_end` まで連続で受信できます。アプリでテキスト読み上げの自動再生が有効な場合は、`tts_message` イベントも届きます。
+- **[テキスト生成を停止](/ja/api-reference/completion-messages/stop-completion-message-generation)**:ストリーミング中の応答を完了前に中断します。
## ファイルの操作
-- **[ファイルをアップロード](/ja/api-reference/files/upload-file)**:画像、ドキュメント、音声、動画ファイルをアップロードし、[完了メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) から参照できるようにします。ファイルはアップロードしたエンドユーザーのみが利用できます。
+- **[ファイルをアップロード](/ja/api-reference/files/upload-file)**:画像、ドキュメント、音声、動画ファイルをアップロードし、[テキスト生成メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) から参照できるようにします。ファイルはアップロードしたエンドユーザーのみが利用できます。
- **[ファイルをダウンロード](/ja/api-reference/files/download-file)**:アップロード済みファイルをプレビューまたはダウンロードします。対象はアプリ内のメッセージに紐づくファイルに限られます。
- **[エンドユーザー取得](/ja/api-reference/end-users/get-end-user-info)**:エンドユーザー ID(ファイルアップロードのレスポンスにある `created_by` など)から、そのユーザーの詳細を取得します。
diff --git a/ja/api-reference/guides/streaming.mdx b/ja/api-reference/guides/streaming.mdx
index 2692566168..18667e4dd9 100644
--- a/ja/api-reference/guides/streaming.mdx
+++ b/ja/api-reference/guides/streaming.mdx
@@ -61,7 +61,7 @@ curl でテストする場合は、`-N`(`--no-buffer`)を付けます。イ
## イベントタイプごとの振り分け
-届くイベントはアプリタイプによって異なります。イベントの一覧は [チャットメッセージを送信](/ja/api-reference/chat-messages/send-chat-message)、[ワークフローを実行](/ja/api-reference/workflow-runs/run-workflow)、[完了メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) の各イベント表を参照してください。
+届くイベントはアプリタイプによって異なります。イベントの一覧は [チャットメッセージを送信](/ja/api-reference/chat-messages/send-chat-message)、[ワークフローを実行](/ja/api-reference/workflow-runs/run-workflow)、[テキスト生成メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) の各イベント表を参照してください。
アプリタイプ別に、一般に最低限必要な処理を示します。
diff --git a/ja/api-reference/openapi_service.json b/ja/api-reference/openapi_service.json
index 23262a8748..fc37bf6288 100644
--- a/ja/api-reference/openapi_service.json
+++ b/ja/api-reference/openapi_service.json
@@ -928,7 +928,7 @@
"type": "string"
},
"task_id": {
- "description": "タスク ID です。リクエストの追跡と、[完了メッセージの生成を停止](/ja/api-reference/completion-messages/stop-completion-message-generation) API の呼び出しに使います。",
+ "description": "タスク ID です。リクエストの追跡と、[テキスト生成を停止](/ja/api-reference/completion-messages/stop-completion-message-generation) API の呼び出しに使います。",
"format": "uuid",
"type": "string"
}
@@ -10271,15 +10271,15 @@
"description": "- `moderation_unavailable` : アプリのコンテンツモデレーション(キーワードまたはカスタム API)が、入力または出力のチェックを完了できませんでした。エンドポイントに接続できない場合や、無効なレスポンスが返された場合などです。\n- `moderation_unavailable` : Dify Cloud で、AI クレジットで動作するモデルの入力または出力に対し、Dify 独自のモデレーションがチェックを完了できませんでした。\n- `moderation_unavailable` : アプリのコンテンツモデレーションが OpenAI モデレーションに設定されていますが、ワークスペースのモデルプロバイダーに有効な OpenAI API キーがありません。Dify Cloud では、アプリのモデルがワークスペース独自の API キーを使う場合にのみ発生します。"
}
},
- "summary": "完了メッセージを送信",
+ "summary": "テキスト生成メッセージを送信",
"tags": [
- "完了メッセージ"
+ "テキスト生成メッセージ"
],
"x-mint": {
"href": "/ja/api-reference/completion-messages/send-completion-message",
"metadata": {
- "sidebarTitle": "完了メッセージを送信",
- "title": "完了メッセージを送信"
+ "sidebarTitle": "テキスト生成メッセージを送信",
+ "title": "テキスト生成メッセージを送信"
}
}
}
@@ -10290,7 +10290,7 @@
"operationId": "stopCompletionGenerationJp",
"parameters": [
{
- "description": "タスク ID です。[完了メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) のストリーミングイベントから取得します。",
+ "description": "タスク ID です。[テキスト生成メッセージを送信](/ja/api-reference/completion-messages/send-completion-message) のストリーミングイベントから取得します。",
"in": "path",
"name": "task_id",
"required": true,
@@ -10356,15 +10356,15 @@
"description": "- `app_unavailable` : アプリケーションが利用できないか、設定が正しくありません。\n- `invalid_param` : 必須の `user` フィールドがありません。"
}
},
- "summary": "完了メッセージの生成を停止",
+ "summary": "テキスト生成を停止",
"tags": [
- "完了メッセージ"
+ "テキスト生成メッセージ"
],
"x-mint": {
"href": "/ja/api-reference/completion-messages/stop-completion-message-generation",
"metadata": {
- "sidebarTitle": "完了メッセージの生成を停止",
- "title": "完了メッセージの生成を停止"
+ "sidebarTitle": "テキスト生成を停止",
+ "title": "テキスト生成を停止"
}
}
}
@@ -44867,7 +44867,7 @@
},
{
"description": "テキスト生成に関連する操作です。",
- "name": "完了メッセージ"
+ "name": "テキスト生成メッセージ"
},
{
"description": "ナレッジベースの作成、設定、取得を含むナレッジベース管理の操作です。",